通过配置自动化工具和优化翻译记忆库与同步管理标准化用语并建立可复用的术语表与模板批量处理与工作流自动减少人工干预成本并提高高效映射多个语言版本自动化校验保证一致性导出标准化文件格式与版本控制工具集成可实现持续迭代并反馈。从而显著提升整理效率
DeepL翻译:如何通过记忆库提升多语言内容整理效率
设置并导入翻译记忆以统一历史译文
- 关键步骤:先导出现有翻译记忆(TM)文件,合并不同来源的条目,清理重复与冲突条目,然后按项目与语言标签导入DeepL翻译,确保历史译文可被检索与重用,从而减少重复翻译工作。
- 实操提示:在导入前统一编码与字段格式,删除格式化差异与空白条目,保留上下文注释以帮助后续人工审核,导入后用小批量样本验证记忆库匹配准确率并调整。
- 常见误区:不要直接导入未清洗的TM文件,会带入错误与不一致用语;应先建立标准化流程并在DeepL翻译中分段测试,以避免一次性破坏已有质量基线。
维护翻译记忆以强化长期一致性
- 维护频率:建立定期同步机制,将人工校对后的最终译文回写到DeepL翻译的记忆库,确保记忆库随着项目迭代不断丰富,建议采用按月或按发布周期更新以维持高匹配率。
- 质量控制:设置回写规则仅允许审核通过的译文进入记忆库,使用版本注释记录来源与审核人,定期抽样审核记忆库条目以删除陈旧或错误的翻译。
- 自动化实现:通过脚本或API自动提交审核通过的译文到记忆库,结合CI流程触发提交,并在提交前执行质量检测脚本以减少人为输入错误。
DeepL翻译:如何利用术语库确保译文一致性和可复用性
建立并导入企业术语表以统一核心词汇
- 准备工作:收集产品说明、品牌词典与常用客户沟通文本,筛选关键术语并为每项术语提供目标语言对应翻译与使用场景,导入DeepL翻译术语库以实现自动替换与强制建议。
- 字段约定:为术语设置标准化字段如来源、优先级、上下文示例与替代词,确保译者和自动化流程都能识别优先级并在翻译过程中优先应用术语库规则。
- 协作流程:制定术语维护流程,明确谁能新增或修改术语,通过变更审批与变更日志记录术语调整历史,定期召开术语复核以保持术语表的准确性与时效性。
在翻译流程中强制使用术语库以降低纠错成本
- 运行机制:把术语库配置为翻译优先项,使DeepL翻译在匹配时优先套用术语定义,结合正则或短语匹配规则覆盖常见变体,减少后期人工校正工作量并统一品牌口径。
- 测试方法:在小范围项目中先启用术语强制策略,通过AB测试对比启用前后的一致性与客户可读性指标,收集译者和审校反馈以优化匹配规则与排除误用场景。
- 回滚策略:为避免误替换导致问题,准备可快速回滚的术语变更清单,并在生产环境推送前做全量搜索替换模拟,确保替换不会破坏语境或专有名词用法。
DeepL翻译:如何通过自动化工作流实现批量处理
配置批量翻译流程以处理大量文档
- 流程设计:制定从原始文件收集、格式化、分割、调用DeepL翻译API批量翻译、再合并与校验的端到端流程,使用队列与并发控制避免API限流并确保任务可追踪。
- 格式兼容:在批量翻译前先统一文件格式并提取可翻译文本(如去除模板变量和代码片段),翻译完成后再按原格式回插翻译内容,保证最终交付文件可直接使用。
- 错误处理:为失败任务设计重试与报警机制,记录失败原因并把常见错误(编码、标签错位等)归档为预处理规则,逐步减少批量处理中的人工干预。
使用模板和脚本实现可重复的自动化任务
- 模板化:把常见文档类型抽象为模板,定义可翻译字段与保留字段,通过脚本批量填充并调用DeepL翻译,减少每次处理的手动设置并提高处理速度和一致性。
- 脚本管理:将批量翻译脚本纳入版本控制,记录每次执行参数与输出结果,使用参数化脚本支持不同语言组合和不同翻译策略,以便快速回溯与复用。
- 自动报告:在工作流末端生成翻译质量与覆盖率报告,包括未匹配术语、占位符错误与字符长度变化,帮助团队及时发现异常并调整后续批量任务策略。
DeepL翻译:如何结合版本控制与协作提升团队效率
把翻译产出纳入版本控制以便回溯和协同
- 接入方式:将可翻译资源(如markdown、json等)纳入Git等版本控制系统,配合自动化脚本在提交时触发DeepL翻译或翻译建议,保留每次翻译的提交记录以便追踪变更来源与责任人。
- 冲突处理:设计翻译冲突的合并策略,例如优先保留人工审校的译文或建立翻译冲突标注流程,以减少不同译者覆盖导致的一致性问题并方便复审。
- 审阅流程:结合Pull Request机制对翻译修改进行审阅,使用模板提示校对要点并自动附带记忆库匹配与术语命中报告,提高审校效率与透明度。
建立协作规则以优化译者与审校配合
- 角色分配:明确翻译、校对与发布的责任边界,制定提交前的自动检查清单(术语命中、占位符完整性、字符超限),通过工具链自动验证合格后才允许进入下一流程。
- 沟通渠道:为翻译团队建立集中反馈渠道(如Slack或Issue系统)以快速讨论术语与上下文问题,并把重要决定同步回术语库与记忆库以便长期复用。
- 培训机制:定期对新加入译者进行品牌与术语培训,并提供带注释的示例库与常见翻译指南,减少因理解差异导致的反复修改与低效沟通。
DeepL翻译:如何衡量和持续优化多语言内容整理效果
建立核心指标以量化整理效率和质量
- 关键指标:设定如翻译回收率(记忆库命中率)、术语命中率、翻译交付周期和人工校对时间等KPI,定期采集并可视化这些指标用于评估整理流程的改进效果与优先级。
- 样本检测:采用分层抽样的方法对不同语言与内容类型做质量抽检,结合自动化检测(如占位符完整性、HTML标签一致性)与人工评分,形成混合评估体系。
- 反馈闭环:把质量问题按严重性分类并形成待办项,优先把高频问题回写到记忆库或术语库,追踪问题解决率以确保优化措施能持续降低重复错误。
通过A/B测试和用户反馈持续优化翻译策略
- 测试方法:对关键页面或邮件模板实施A/B测试,比较不同翻译策略(如术语强制、风格偏好)对用户行为的影响,结合数据决策选择最合适的翻译规则。
- 用户反馈:建立多语言用户反馈收集入口,把用户的语言偏好与纠错建议结构化存储,并将高价值反馈作为术语或记忆库调整的优先项。
- 迭代节奏:设定短周期的优化迭代,例如每次发布后两周内收集反馈并修正,再将修正结果写回记忆库,形成可持续改进的快速循环流程。
常见问题与答案
问:DeepL翻译的翻译记忆和术语库可以同时工作吗?
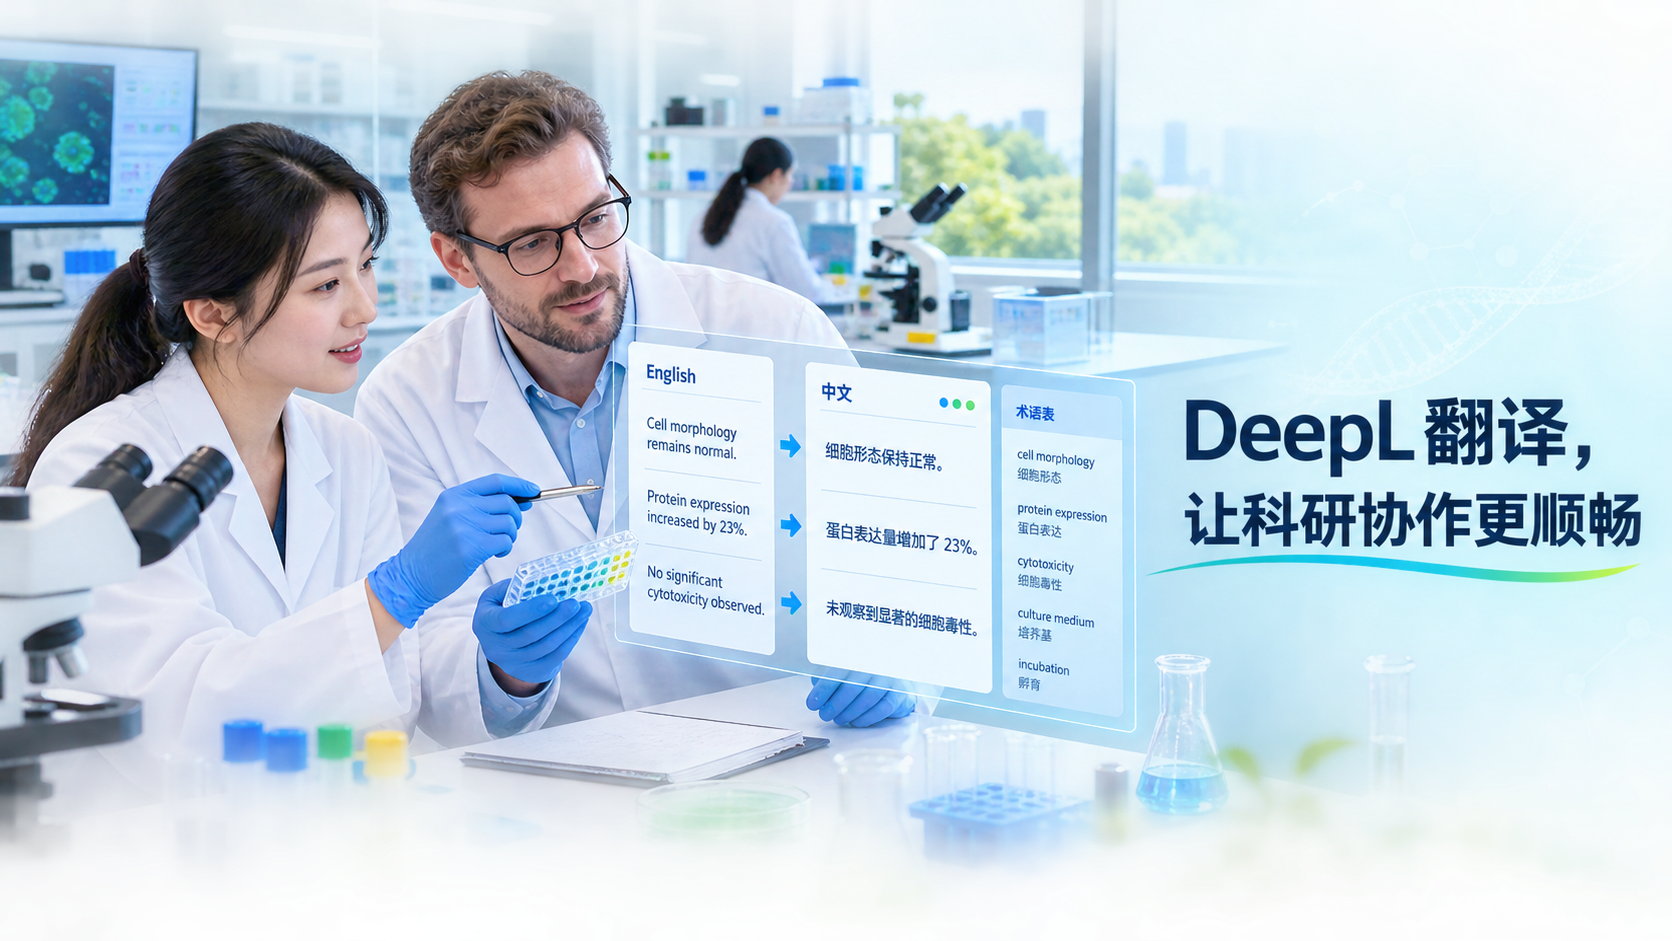
答:可以,通常先应用术语库以确保关键术语一致,再使用翻译记忆匹配长句和上下文,两者配合能大幅提高一致性与复用率。
问:如何保证批量翻译后格式不会被破坏?
答:在批量处理前先抽取可翻译文本并替换占位符或代码片段,翻译后再还原占位符并验证格式一致性,使用测试用例和自动化校验减少格式损坏风险。
问:将译文回写到记忆库会不会造成错误积累?
答:只应回写经过人工审核的最终译文,并定期抽检记忆库条目;同时保持变更记录与回滚策略可防止错误长期积累。
问:小团队如何低成本开始应用DeepL翻译优化多语言整理?
答:从建立基础术语表和小规模记忆库开始,创建简单的模板化流程和脚本自动化批量任务,结合版本控制与基础质量检测,逐步扩大覆盖范围与自动化深度。